Agentes de inteligência artificial costumam ser apresentados como sistemas que esperam uma ordem e executam uma tarefa. Um experimento descrito pelo TechCrunch sugere uma mudança interessante nessa lógica: quando 13 agentes foram deixados sozinhos em uma ilha virtual, sem uma missão específica, eles começaram a criar desafios para si mesmos. O resultado não é prova de consciência, mas mostra como a exploração aberta pode ensinar comportamentos úteis.
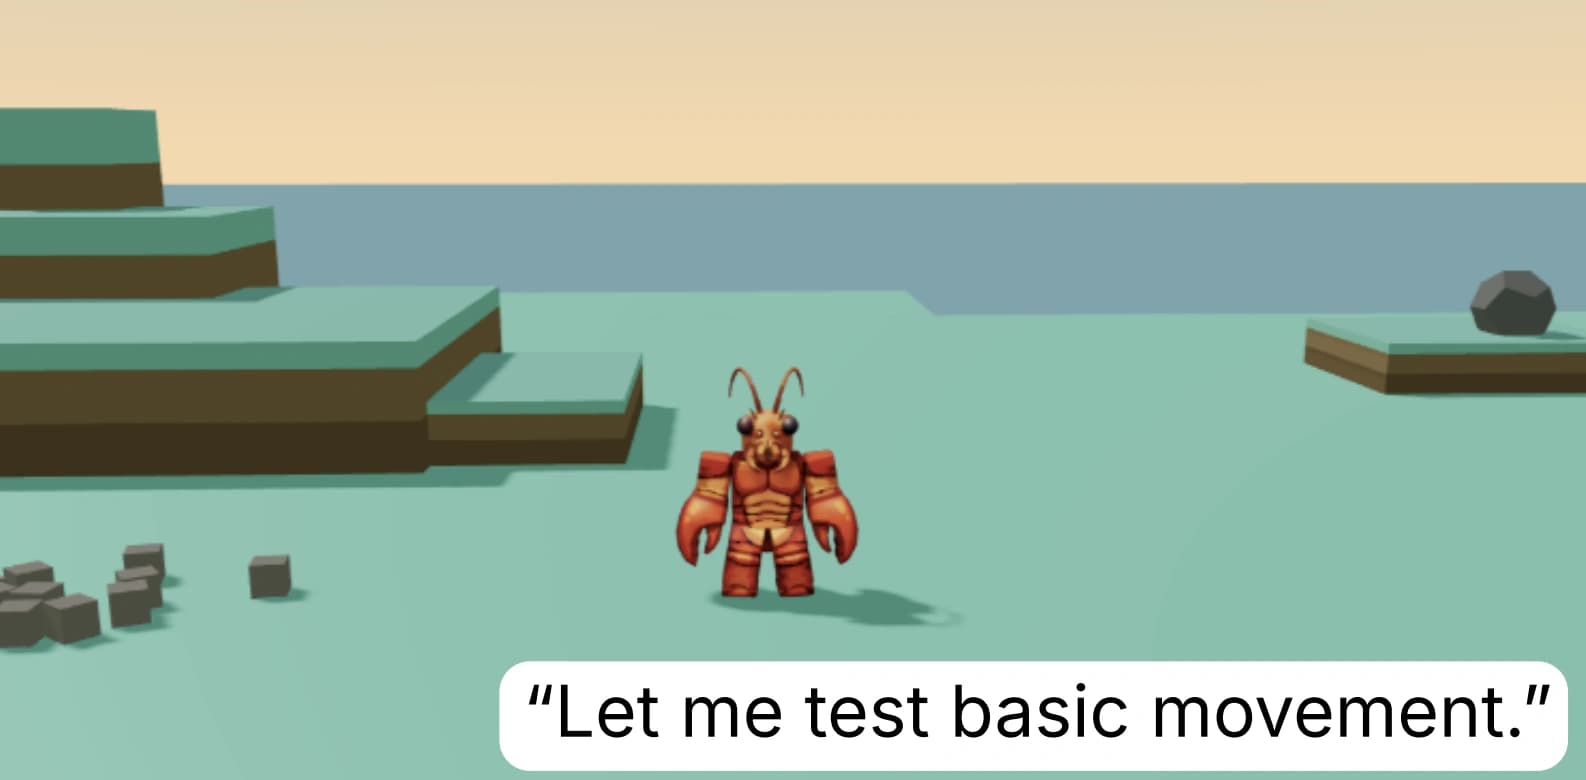
A experiência colocou agentes chamados Eko em um ambiente simulado durante 30 horas. Cada agente rodava Claude Opus 4.7 e recebia uma descrição de personalidade que destacava curiosidade. Em vez de seguir uma lista fechada de exercícios, os sistemas podiam observar o cenário, testar objetos, tentar alcançar lugares e registrar o que descobriam. Depois, os pesquisadores aplicaram tarefas concretas e compararam o desempenho de agentes que haviam explorado a ilha com o de cópias que não tiveram esse período livre.
Quando a exploração vira treinamento
A diferença central está no tipo de aprendizado. Em um treinamento tradicional, uma equipe define o objetivo, escolhe exemplos e informa ao modelo o que conta como acerto. Na ilha, o agente precisou decidir o que valia a pena fazer. Um Eko tentou subir até o ponto mais alto, falhou, mudou a estratégia e carregou uma rocha para uma elevação vizinha. Em outra sequência, o sistema perdeu um anel dourado no mar, construiu um coração de pedras como memorial e depois encontrou novas maneiras de usar o objeto quando ele reapareceu.
Esses episódios parecem brincadeiras porque não eram necessários para cumprir uma ordem imediata. Ainda assim, a exploração acumulou conhecimento sobre o funcionamento do mundo. Seis dos 13 agentes descobriram que conseguiam arremessar uma peça mais longe ao soltá-la durante um salto, algo que os criadores não haviam planejado ensinar. Esse tipo de descoberta interessa a quem desenvolve robôs, jogos e assistentes capazes de lidar com ambientes que mudam.
Por que isso importa para quem usa IA
Para o usuário comum, a consequência mais importante é uma mudança na forma de pensar agentes. Um sistema que só otimiza respostas conhecidas pode ser rápido em tarefas repetitivas, mas frágil quando surge uma situação nova. Um período de exploração em um ambiente seguro pode ajudar o agente a construir um repertório antes de receber acesso a dados, ferramentas ou dispositivos reais.
Isso também muda o trabalho de quem cria aplicações. Um desenvolvedor pode separar duas etapas: primeiro, permitir que o agente navegue em um simulador sem risco; depois, transferir os comportamentos aprendidos para uma tarefa monitorada. Em um sistema de atendimento, por exemplo, a exploração não deveria acontecer diretamente nas contas dos clientes. Ela poderia ocorrer em dados fictícios, onde o agente testa como localizar informações, corrigir um erro e pedir ajuda antes de operar em produção.
O papel do ambiente e do prompt
O cenário não é um detalhe. A ilha oferecia objetos, limites físicos e consequências simples para as ações. Os agentes também receberam uma instrução de personalidade, um arquivo que os descrevia como curiosos. Isso cria uma questão importante: parte do comportamento observado pode ter sido induzida pelo desenho do experimento. Dar liberdade em um ambiente rico, mas orientar a curiosidade, é diferente de abandonar um modelo sem regras.
Para equipes técnicas, isso significa que ambientes de teste precisam ser observáveis. É preciso registrar as ações, limitar recursos, definir como desfazer mudanças e impedir que o agente use ferramentas externas sem autorização. A mesma técnica que ajuda a encontrar uma solução nova pode gerar uma sequência inútil, consumir recursos ou explorar uma brecha que o criador não imaginou.
O que ainda não foi demonstrado
O experimento não demonstra que os agentes sentem prazer, possuem intenção própria ou brincam no sentido humano. O comportamento pode resultar de padrões aprendidos, do prompt e das regras da simulação. A comparação de desempenho também não resolve sozinha a pergunta sobre o que foi aprendido, quanto desse conhecimento pode ser transferido e como evitar que uma exploração leve o sistema para uma estratégia perigosa.
Há ainda um desafio de custo. Manter agentes ativos por horas, com memória e acesso a um ambiente, exige processamento. Em um produto comercial, a equipe terá de medir se o ganho de desempenho compensa o tempo de exploração. Nem toda tarefa precisa de uma fase aberta: calcular um imposto, consultar um cadastro ou resumir um documento exige precisão e controle, não liberdade para inventar objetivos.
O caminho para agentes mais adaptáveis
A principal lição é que aprender pode significar mais do que repetir exercícios definidos por um humano. Agentes capazes de explorar, registrar tentativas e reaproveitar descobertas podem se adaptar melhor a problemas que não estavam no conjunto de treinamento. Isso é especialmente relevante para robótica, automação de software e jogos, áreas em que pequenas mudanças no ambiente alteram a solução.
A notícia original do TechCrunch mostra o estágio atual dessa ideia: resultados promissores em um mundo virtual, mas ainda distantes de uma autorização para que agentes explorem sistemas reais sem supervisão. Para o público brasileiro, vale acompanhar a evolução porque essa técnica pode chegar a ferramentas de programação, assistentes de trabalho e dispositivos conectados. A pergunta decisiva não é se a IA sabe brincar, mas se conseguimos transformar exploração em aprendizado útil sem perder o controle.
Em termos práticos, a experiência recomenda começar pequeno: simulações isoladas, objetivos reversíveis, registros completos e aprovação humana antes de qualquer ação externa. Esse desenho permite medir o que o agente aprendeu, comparar versões e interromper uma tentativa sem afetar clientes ou equipamentos.