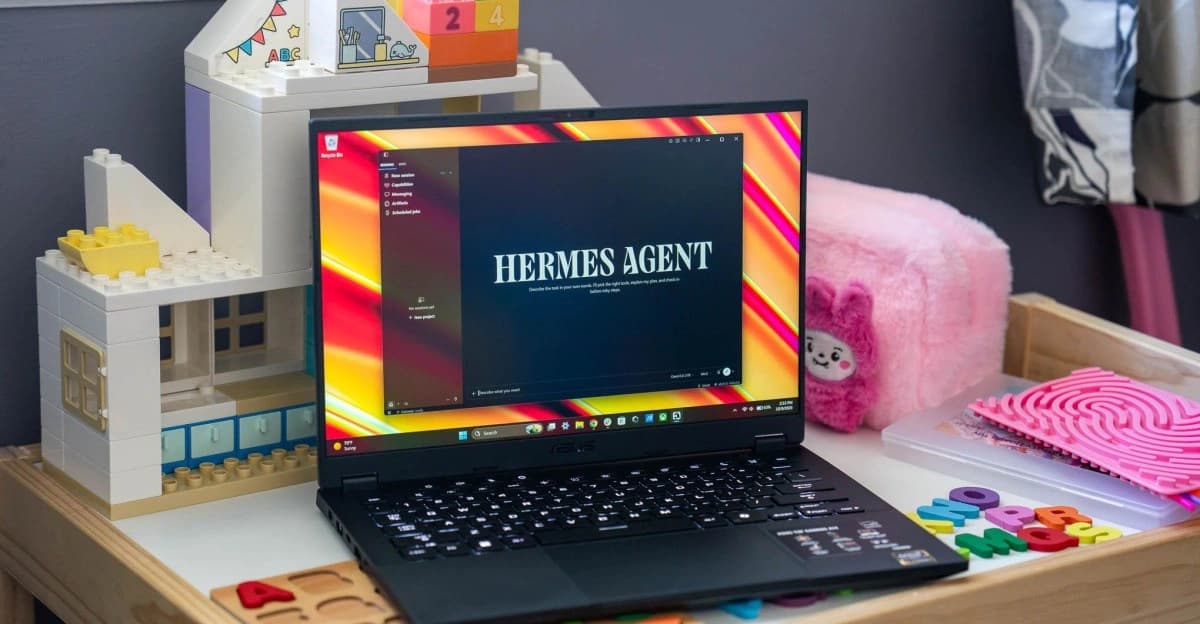
Rodar um modelo de inteligência artificial no próprio computador parece uma resposta direta à preocupação com privacidade. Os dados não precisam ser enviados a um serviço remoto, e o usuário pode escolher o modelo, o hardware e as permissões. Na prática, a experiência ainda está longe de ser simples. Uma reportagem do The Verge, publicada em 11 de outubro de 2026, acompanha os primeiros testes de um agente local e mostra tanto o potencial quanto o trabalho envolvido.
O autor instalou o Hermes Agent em computadores Mac e Windows e usou um modelo Qwen de 125 bilhões de parâmetros, com cerca de 105 GB. A escolha exige uma máquina com muita memória e ilustra um ponto que costuma ser escondido por demonstrações de software: privacidade local pode custar caro. Além do investimento, existe o tempo para instalar modelos, corrigir falhas e escolher tarefas que realmente se beneficiem da execução no dispositivo.
O que significa executar IA localmente
Em um serviço de nuvem, o usuário envia uma solicitação para servidores remotos, que processam o modelo e devolvem o resultado. Na IA local, os pesos do modelo e o processamento ficam no computador. Isso pode reduzir a circulação de documentos pessoais, planilhas financeiras, códigos sob embargo e outras informações que uma equipe não quer colocar em uma plataforma externa.
Local não significa automaticamente seguro. O programa instalado ainda pode ter acesso a arquivos, aplicativos e contas. Um agente também pode usar a internet, enviar informações para integrações externas ou guardar históricos em um diretório que outras pessoas conseguem ler. A privacidade depende do conjunto de software, permissões e configuração, não apenas do local onde o modelo calcula a resposta.
O primeiro obstáculo é escolher o modelo
O teste do The Verge mostra como o catálogo de modelos se tornou difícil de acompanhar. Há opções grandes, pequenas, especializadas, abertas e ajustadas para diferentes tarefas. Modelos com mais parâmetros costumam exigir mais memória e podem realizar tarefas complexas, mas o tamanho não é uma garantia de precisão. Um modelo menor pode ser mais rápido e suficiente para resumir arquivos ou classificar documentos.
A decisão deve partir do tipo de dado e da tarefa. Para um briefing diário com agenda e clima, velocidade e baixo consumo podem ser mais importantes do que raciocínio sofisticado. Para comparar contratos ou analisar código, uma equipe pode aceitar uma execução mais lenta se o modelo for capaz de manter contexto. Em todos os casos, o resultado precisa ser revisado antes de alimentar outra automação.
O custo de memória também muda a escolha do computador. Um modelo de 100 GB não cabe confortavelmente em qualquer notebook, mesmo que o arquivo possa ser armazenado em disco. A execução precisa de memória para o modelo, o sistema operacional e o contexto da conversa. Quando a máquina começa a usar armazenamento como memória, a velocidade cai e a experiência pode se tornar frustrante.
Agentes locais são úteis em tarefas estreitas
O experimento usou o Hermes para criar um briefing diário, organizar uma biblioteca de jogos, analisar registros financeiros e comparar especificações de notebooks. São tarefas interessantes porque lidam com informações pessoais e repetitivas. O agente pode ler arquivos, chamar ferramentas e devolver uma organização que levaria tempo para ser feita manualmente.
O caso da biblioteca de jogos é um bom exemplo de autonomia limitada. O agente recebeu uma meta, sugeriu categorias e reorganizou os títulos depois que o usuário escolheu a opção. Para acessar a biblioteca, foi necessário fornecer uma chave de API do Steam. A chave podia ser revogada depois, mas a experiência mostra por que credenciais devem ter escopo e duração mínimos.
Em um ambiente profissional, o mesmo princípio vale para documentos e sistemas internos. Comece com uma pasta de teste, dados fictícios e ações que possam ser desfeitas. Não ofereça acesso permanente a todo o disco ou a uma conta pessoal. Um agente deve receber exatamente a permissão necessária para a tarefa, e o usuário precisa saber quando essa permissão foi usada.
Privacidade melhora, mas a complexidade aumenta
A vantagem mais clara dos modelos locais é manter arquivos sensíveis dentro do dispositivo. Isso pode ajudar uma equipe de produto a analisar um protótipo sob embargo ou uma pessoa a organizar registros pessoais sem subir o conteúdo para a nuvem. Também reduz a dependência de planos pagos, limites de uso e mudanças de política de um fornecedor.
O outro lado é a responsabilidade operacional. A equipe precisa atualizar o modelo, proteger o computador, controlar os logs e monitorar o consumo de recursos. Uma falha na configuração pode deixar prompts e respostas em arquivos de texto. Um plugin malicioso pode capturar os dados antes de o modelo processá-los. A arquitetura local elimina um fornecedor remoto, mas não elimina a necessidade de segurança.
Também há uma diferença entre privacidade e confidencialidade. Um modelo pode não enviar os dados para a internet e ainda revelar parte de um documento em uma tela compartilhada ou em um arquivo de saída. O processo precisa controlar o acesso ao resultado, a retenção de histórico e o descarte de temporários.
O papel do hardware especializado
Fabricantes estão apresentando computadores com muita memória e componentes voltados à execução local de modelos. A proposta interessa a desenvolvedores, pesquisadores e usuários avançados porque reduz a dependência de servidores. Mas o preço de uma máquina poderosa pode superar o custo de vários anos de uma assinatura em nuvem.
A comparação precisa incluir mais do que o valor do computador. Considere consumo de energia, manutenção, atualização de memória, tempo de configuração e suporte. Um fluxo local pode ser vantajoso quando os dados não podem sair do ambiente ou quando a equipe executa muitas tarefas repetitivas. Para uma consulta ocasional, a nuvem pode continuar sendo mais prática, desde que a política de dados seja aceitável.
O Brasil enfrenta ainda diferenças de disponibilidade e preço. Componentes de alto desempenho podem chegar mais tarde e custar mais, e nem todo modelo tem suporte otimizado para português. Antes de comprar hardware, teste modelos menores no equipamento atual e meça o ganho real.
O que desenvolvedores podem aprender
A experiência descrita pelo The Verge revela que a interface do agente é tão importante quanto o modelo. Um seletor de modelos facilita o começo, mas não resolve a pergunta principal: o que fazer com a ferramenta. Bons produtos oferecem exemplos de tarefas, mostram quais arquivos serão usados e explicam os limites. A conversa deve ser acompanhada por um histórico de ações e por confirmações claras.
Para a engenharia, agentes locais criam oportunidades em automação de desenvolvimento, testes e análise de dados. Um modelo pode gerar scripts para executar benchmarks, organizar resultados e preparar um relatório. Ainda assim, o script deve ser revisado e executado em um ambiente isolado. A autonomia ajuda quando reduz trabalho repetitivo, mas o código produzido continua sujeito a erros.
Uma escolha prática para o dia a dia
IA local faz mais sentido quando privacidade, controle e disponibilidade offline são requisitos concretos. Ela é menos atraente quando o usuário precisa de um modelo sempre atualizado, pouca configuração e capacidade de processamento variável. A melhor estratégia pode ser híbrida: manter documentos sensíveis no computador e usar a nuvem apenas para tarefas de baixo risco, com regras de classificação claras.
O teste do The Verge não apresenta um assistente mágico. Ele mostra uma tecnologia em formação, que pode ser muito útil quando recebe um problema específico e permissões limitadas. Para o leitor brasileiro, a principal lição é calcular o custo completo da privacidade e começar pequeno. Antes de comprar uma máquina cara, escolha uma tarefa reversível, instale um modelo compatível e observe se a autonomia realmente economiza tempo sem criar um novo risco.
Fonte original: The Verge, Learning to use local AI is exciting, overwhelming, and frustrating.