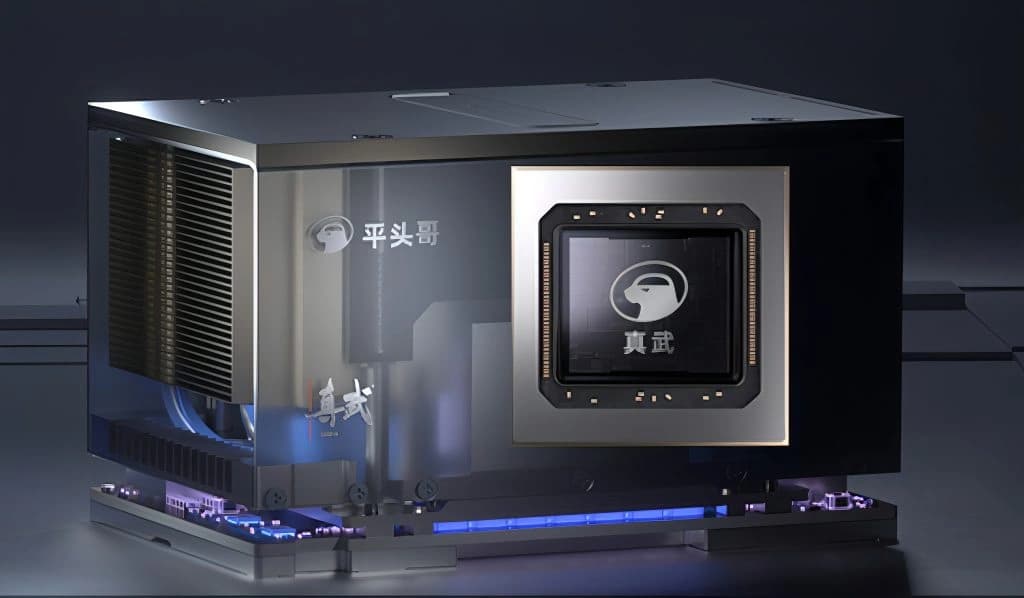
A Alibaba apresentou o Zhenwu V900, um acelerador criado para treinar e executar modelos de inteligência artificial. O componente tem 216 GB de memória e foi projetado para trabalhar em sistemas com mais de mil chips conectados. A empresa afirma que ele entrega três vezes o desempenho do modelo anterior, mas ainda não divulgou dados suficientes para que a comparação seja verificada de forma independente.
O anúncio, publicado pelo Tecnoblog, ajuda a entender uma parte da corrida da IA que costuma aparecer menos nas telas: a infraestrutura necessária para transformar um modelo em serviço. Aplicativos de conversa, ferramentas de programação e sistemas de recomendação dependem de grandes conjuntos de processadores. A quantidade de memória, a comunicação entre chips e o consumo de energia podem determinar quanto custa operar cada resposta.
Treinamento e inferência exigem recursos diferentes
O Zhenwu V900 foi anunciado para duas tarefas centrais. O treinamento é a fase em que o modelo processa dados e ajusta seus parâmetros. É um trabalho pesado e prolongado, que distribui cálculos por muitos aceleradores. A inferência acontece quando o modelo já treinado recebe uma solicitação e calcula a resposta. Ela pode parecer mais simples, mas fica cara quando milhões de pessoas usam o serviço ao mesmo tempo.
Ter 216 GB de memória em um único acelerador pode ajudar a manter partes maiores de um modelo próximas do processamento. Isso reduz a necessidade de mover dados constantemente entre componentes e pode melhorar o aproveitamento do sistema. A quantidade, sozinha, não garante que o chip será rápido em todas as cargas. O desempenho depende da arquitetura, do software, da largura de banda e da forma como os modelos são divididos.
O Tecnoblog informa que o V900 oferece largura de banda de 1.200 GB por segundo na comunicação entre chips. O modelo anterior, o Zhenwu M890, teria 144 GB de memória e 800 GB por segundo. Esses números apontam para um esforço de aumentar não apenas a capacidade de cada peça, mas também a velocidade da rede que conecta o conjunto.
Mais de mil chips em um sistema
A divisão de semicondutores T-Head, pertencente à Alibaba, afirma que mais de mil unidades poderão trabalhar como um único sistema. Em uma escala ainda maior, a companhia fala em clusters com até 500 mil placas. Um cluster é um grupo de computadores e aceleradores que compartilham tarefas, memória e comunicação para executar um trabalho que seria grande demais para uma única máquina.
Esse tipo de arquitetura aparece quando empresas precisam treinar modelos com muitos parâmetros ou atender a uma grande quantidade de usuários. Distribuir o trabalho permite expandir a capacidade, mas também aumenta a complexidade. Se a comunicação entre os componentes for lenta, a vantagem de adicionar mais chips diminui. Se uma unidade falhar, o sistema precisa saber como redistribuir a tarefa sem perder horas de processamento.
Por isso, o chip é apenas uma parte da história. Data centers precisam de placas, redes, refrigeração, armazenamento, fontes de energia e ferramentas de gerenciamento. O software também deve conhecer o acelerador para aproveitar sua memória e seus mecanismos de cálculo. Uma solução proprietária pode ganhar eficiência em alguns cenários, mas exige que desenvolvedores adaptem bibliotecas e modelos.
O que ainda não foi informado
A Alibaba ainda não divulgou o desempenho em FLOPS, uma medida usada para estimar a quantidade de operações de ponto flutuante que um sistema realiza. Também não informou o processo de fabricação, a empresa responsável pela produção física do componente ou o consumo de energia. Sem essas informações, é impossível comparar o V900 com aceleradores concorrentes de maneira completa.
Essa ausência não invalida o anúncio, mas exige cuidado com a afirmação de que o V900 seria o chip de IA mais poderoso da China. Trata-se de uma declaração do fabricante, não de um resultado confirmado por testes independentes. Para compradores e operadores de data centers, desempenho por watt, custo total e disponibilidade podem ser tão importantes quanto a quantidade de memória.
Também é preciso esperar a produção em massa. A companhia prevê lançamento comercial no primeiro trimestre de 2027. Até lá, especificações podem mudar, versões de desenvolvimento podem ter resultados diferentes dos produtos finais e o ecossistema de software pode amadurecer. O cronograma indica intenção industrial, não disponibilidade imediata para empresas brasileiras.
O vínculo com os modelos Qwen
O Tecnoblog relaciona o novo acelerador aos planos da Alibaba de treinar modelos Qwen entre 5 trilhões e 10 trilhões de parâmetros. Parâmetros são valores internos que um modelo ajusta durante o treinamento para reconhecer padrões e produzir respostas. Mais parâmetros podem ampliar a capacidade em algumas tarefas, mas não são uma medida isolada de qualidade.
Modelos maiores também ampliam a necessidade de memória, rede e energia. O V900 aparece, portanto, como parte de uma estratégia para controlar uma cadeia inteira: hardware, data centers, modelos e serviços. A empresa pretende superar 20 gigawatts de capacidade de data centers até 2032, segundo a reportagem. A escala mostra por que a disputa por IA não é somente uma competição de aplicativos.
O impacto para desenvolvedores e empresas brasileiras
Para quem desenvolve no Brasil, a notícia reforça a importância de observar a portabilidade dos modelos. Um sistema criado para um acelerador específico pode exigir ajustes quando migra para outra nuvem ou para outro fornecedor. Bibliotecas compatíveis, APIs estáveis e documentação clara reduzem esse risco. Também vale avaliar se a infraestrutura escolhida permite executar modelos menores localmente, em vez de depender sempre de clusters gigantes.
O avanço de chips chineses pode aumentar a diversidade da oferta global e reduzir a dependência de um pequeno grupo de fornecedores. Isso não significa que o produto estará disponível no país ou que terá preço competitivo. A chegada a mercados internacionais depende de distribuição, suporte, regras comerciais e compatibilidade de software.
O Zhenwu V900 merece atenção porque mostra uma tendência concreta: os ganhos da inteligência artificial dependem cada vez mais de componentes especializados e sistemas distribuídos. A promessa de três vezes o desempenho precisa ser confirmada em testes, mas a combinação de memória, comunicação e escala indica onde a indústria está concentrando seus esforços. Para o usuário final, a consequência pode aparecer em serviços mais rápidos, modelos maiores e custos de processamento disputados por várias plataformas.
Fonte da pauta
Este artigo foi adaptado, em próprias palavras, da matéria publicada pelo Tecnoblog em 24 de setembro de 2026.