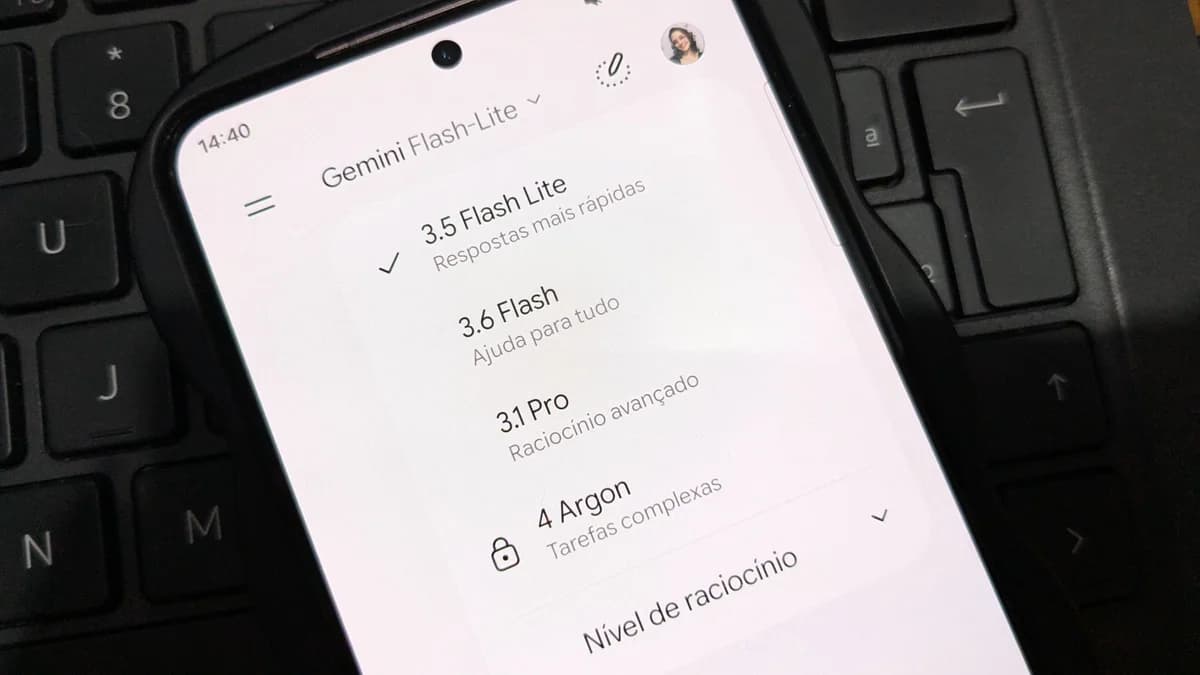
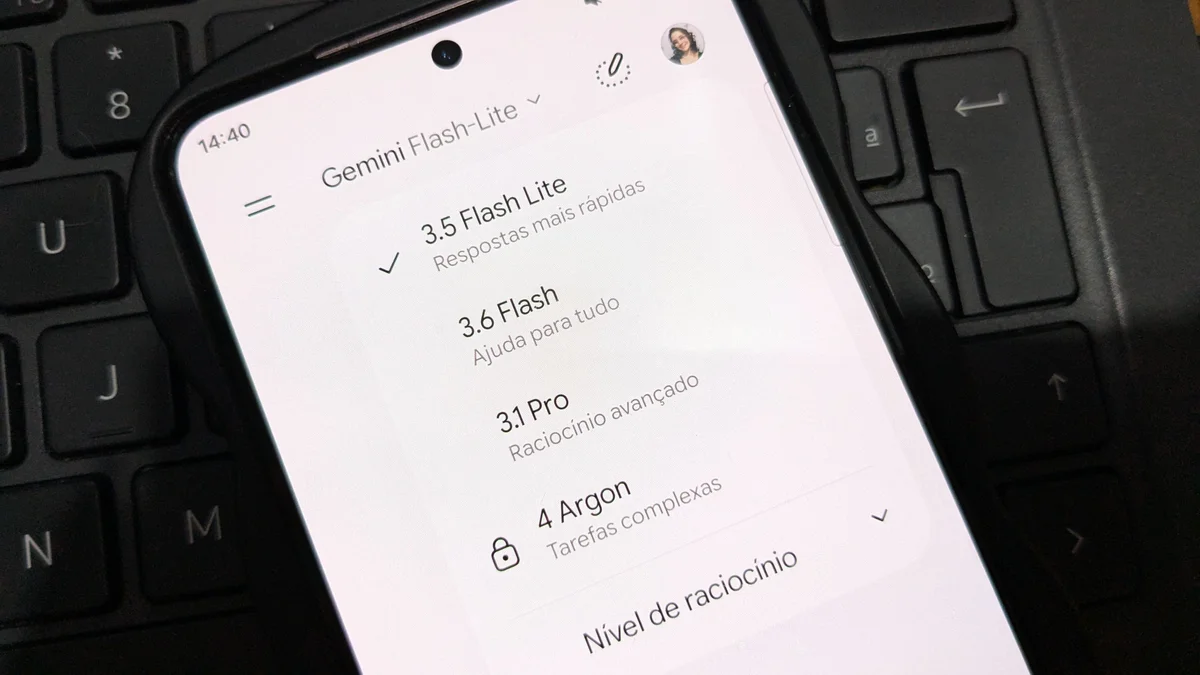
O Google transformou o Gemini em uma família de modelos, não em uma única ferramenta. Para quem abre o aplicativo e encontra nomes como Flash-Lite, Flash, Pro e Argon, a escolha pode parecer uma disputa por números maiores. Na prática, o modelo mais avançado nem sempre é o melhor. Uma tarefa simples pode ficar mais lenta, gastar mais cota e receber uma resposta mais complicada do que precisa.
O Canaltech publicou em 8 de novembro um guia sobre as diferenças entre as versões. O princípio central é direto: comece pelo modelo que atende à tarefa e suba de nível quando houver uma necessidade concreta de raciocínio, contexto ou execução. Essa abordagem vale para o Gemini e para qualquer serviço de IA que ofereça modelos com custos e capacidades diferentes.
Comece pela tarefa, não pelo nome do modelo
Modelos de linguagem têm uma tendência a parecer mais úteis quando fazem algo complexo. Isso não significa que devam ser usados em todas as solicitações. Responder a uma pergunta direta, reescrever uma frase ou extrair dados de uma lista não exige o mesmo esforço de analisar um contrato extenso, depurar um sistema ou planejar um projeto com várias etapas.
Escolher o modelo certo é parecido com escolher uma ferramenta de desenvolvimento. Você não usa um banco de dados distribuído para guardar uma configuração pequena e não executa uma compilação completa para testar uma mudança de uma linha. A ferramenta pesada existe para casos em que seu custo se justifica.
O guia do Canaltech separa os modelos por velocidade, capacidade de raciocínio e complexidade. Essa divisão é mais útil que decorar uma tabela porque ajuda o usuário a fazer uma pergunta operacional: o problema exige apenas transformação de texto ou exige planejamento e verificação de várias relações?
Gemini 3.5 Flash-Lite para tarefas rápidas
O Gemini 3.5 Flash-Lite é a opção mais leve da lista. Ele foi descrito como adequado para respostas diretas, reescrita de frases, e-mails profissionais curtos, resumos menores, ideias simples, explicações objetivas e organização de anotações. Também aceita texto, imagens, vídeo, áudio e PDF, embora a resposta seja gerada em texto.
Esse perfil atende a grande parte das tarefas de rotina. Um usuário pode pedir que o modelo transforme notas de uma reunião em uma lista de pendências, extraia datas de um documento ou sugira títulos para um texto. Uma equipe pode usá-lo para classificar mensagens e criar rascunhos que serão revisados por uma pessoa.
O modelo deixa de ser a escolha ideal quando a tarefa depende de muitas etapas de lógica, pesquisa aprofundada ou programação complexa. Isso não significa que ele não possa tentar. Significa que a chance de respostas superficiais e erros de encadeamento aumenta quando o problema passa do escopo leve.
Gemini 3.8 Flash para equilíbrio
O Gemini 3.8 Flash ocupa uma posição intermediária. Ele combina velocidade com maior capacidade de raciocínio e pode analisar documentos longos, cruzar informações, planejar viagens com várias restrições, explicar conceitos difíceis, comparar produtos e interpretar planilhas complexas.
Um ponto importante é o ajuste do nível de raciocínio. A pessoa pode aumentar o esforço quando a solicitação exigir análise mais cuidadosa e reduzi-lo quando o trabalho for simples. Isso evita trocar de modelo toda vez que a complexidade muda. Para profissionais digitais, essa configuração pode ser útil em fluxos que começam com triagem e terminam com validação detalhada.
Na programação, o Canaltech cita a capacidade de identificar e corrigir erros de código na plataforma Antigravity. Ainda assim, a saída deve ser revisada. Um modelo que encontra um problema pode introduzir outro ao alterar uma parte do programa. O ideal é pedir explicação da mudança, testar em um ambiente isolado e conferir os efeitos sobre dependências e casos de borda.
Gemini 3.1 Pro para precisão
O Gemini 3.1 Pro faz sentido quando a precisão e a qualidade são mais importantes que a resposta imediata. Ele foi indicado para instruções complexas, análises profundas e problemas com etapas interligadas. Também pode gerar animações em SVG a partir de texto e construir interfaces e painéis interativos com código.
Um bom uso é tratar o Pro como uma segunda camada de revisão. Se o Flash produzir uma resposta que parece superficial ou ignorar uma parte importante do pedido, o Pro pode receber a pergunta original, o resultado anterior e uma lista explícita do que precisa ser conferido. Essa estratégia evita usar o modelo mais caro em todos os passos, mas cria uma verificação quando a tarefa pede mais rigor.
O nome Pro não garante que a resposta esteja correta. Ele apenas aumenta a capacidade disponível para lidar com contexto e raciocínio. Dados incompletos, instruções ambíguas e fontes desatualizadas continuam produzindo resultados frágeis. A validação humana continua sendo parte do processo.
Gemini 4 Argon para projetos complexos
O Gemini 4 Argon aparece como o modelo mais avançado da família apresentada pelo Canaltech. Ele foi projetado para problemas que exigem planejamento detalhado, análise extensa e execução autônoma de várias etapas. O guia cita engenharia de software, bases de código grandes, matemática e ciência avançadas, investigação de falhas técnicas e criação de aplicações interativas.
Esse modelo também pode apoiar fluxos de trabalho empresariais e tarefas que envolvem documentos extensos, relações entre relatórios e entregas estruturadas. O ponto central é que ele não deve ser encarado como um botão mágico. Quanto mais autonomia o usuário concede, mais importante fica definir limites, permissões, checkpoints e critérios de sucesso.
Para uma equipe de desenvolvimento, isso pode significar dividir o trabalho em etapas: primeiro mapear o repositório, depois propor mudanças, em seguida gerar testes e só então abrir um pedido de revisão. Para uma área administrativa, significa separar leitura, classificação, recomendação e ação. O modelo pode ajudar em cada etapa, mas não precisa executar tudo sem supervisão.
Como decidir em cinco perguntas
Antes de escolher, pergunte se a tarefa é uma transformação simples ou uma investigação. Se for um resumo curto, uma reescrita ou uma lista, comece no Flash-Lite. Se houver vários documentos, restrições e comparações, teste o Flash. Se o pedido exigir instruções complexas, revisão de código ou uma resposta com mais precisão, considere o Pro. Se houver projeto longo, autonomia e várias etapas, o Argon pode ser apropriado.
Depois, avalie o custo do erro. Um erro em uma sugestão de título é fácil de corrigir. Um erro em uma análise financeira, em uma configuração de segurança ou em uma alteração de código pode ser caro. Quanto maior o impacto, mais importante é usar revisão, testes e uma camada de verificação, independentemente do modelo.
Também observe o tamanho do contexto. Um documento extenso pode exigir uma versão que lide melhor com muitos trechos, mas isso não elimina a necessidade de separar fontes e instruções. Colocar tudo em um único pedido dificulta a auditoria e aumenta a chance de o modelo perder um detalhe.
O que muda para usuários no Brasil
O princípio de escolher pelo trabalho é especialmente útil para usuários brasileiros que lidam com limites de uso, planos pagos e documentos em português. Um modelo leve pode resolver e-mails, resumos e organização diária sem consumir a capacidade destinada a tarefas maiores. Para programação e análise, a pessoa pode reservar os modelos mais fortes para momentos em que eles realmente fazem diferença.
É importante conferir disponibilidade, idioma, limites e integrações na conta usada. O guia do Canaltech descreve as capacidades dos modelos, mas a liberação de uma função pode variar por plano, região e aplicativo. O usuário não deve presumir que um nome apresentado no material esteja disponível em todas as interfaces ou que todas as ferramentas funcionem da mesma maneira.
Uma rotina eficiente começa com o modelo menor, mede a qualidade da resposta e sobe de nível apenas quando necessário. Esse processo também melhora a clareza do trabalho. Em vez de dizer que a IA falhou de forma genérica, a equipe consegue apontar que faltou contexto, raciocínio, ferramenta ou validação.
Menos é mais quando a tarefa é simples
A multiplicação de modelos pode parecer confusa, mas ela também permite usar IA de forma mais responsável. Nem toda pergunta merece o maior sistema disponível. Usar a versão certa reduz tempo de espera, consumo de tokens e custo, além de tornar o fluxo mais previsível.
O melhor ponto de partida é descrever o resultado desejado e o risco envolvido. Depois, escolha o modelo que consegue cumprir a tarefa com margem suficiente e adicione revisão onde o erro seria importante. A recomendação do Canaltech pode ser resumida em uma frase: comece pelo Flash e recorra ao Pro ou ao Argon quando a complexidade pedir, não apenas porque o nome parece mais avançado.
Para quem trabalha com desenvolvimento ou conteúdo, essa escolha também facilita a governança. É possível registrar qual modelo foi usado, comparar resultados e criar regras para tarefas sensíveis. O modelo deixa de ser uma preferência pessoal e passa a fazer parte de um processo que pode ser medido e melhorado.
Fonte principal: matéria original publicada por Canaltech.