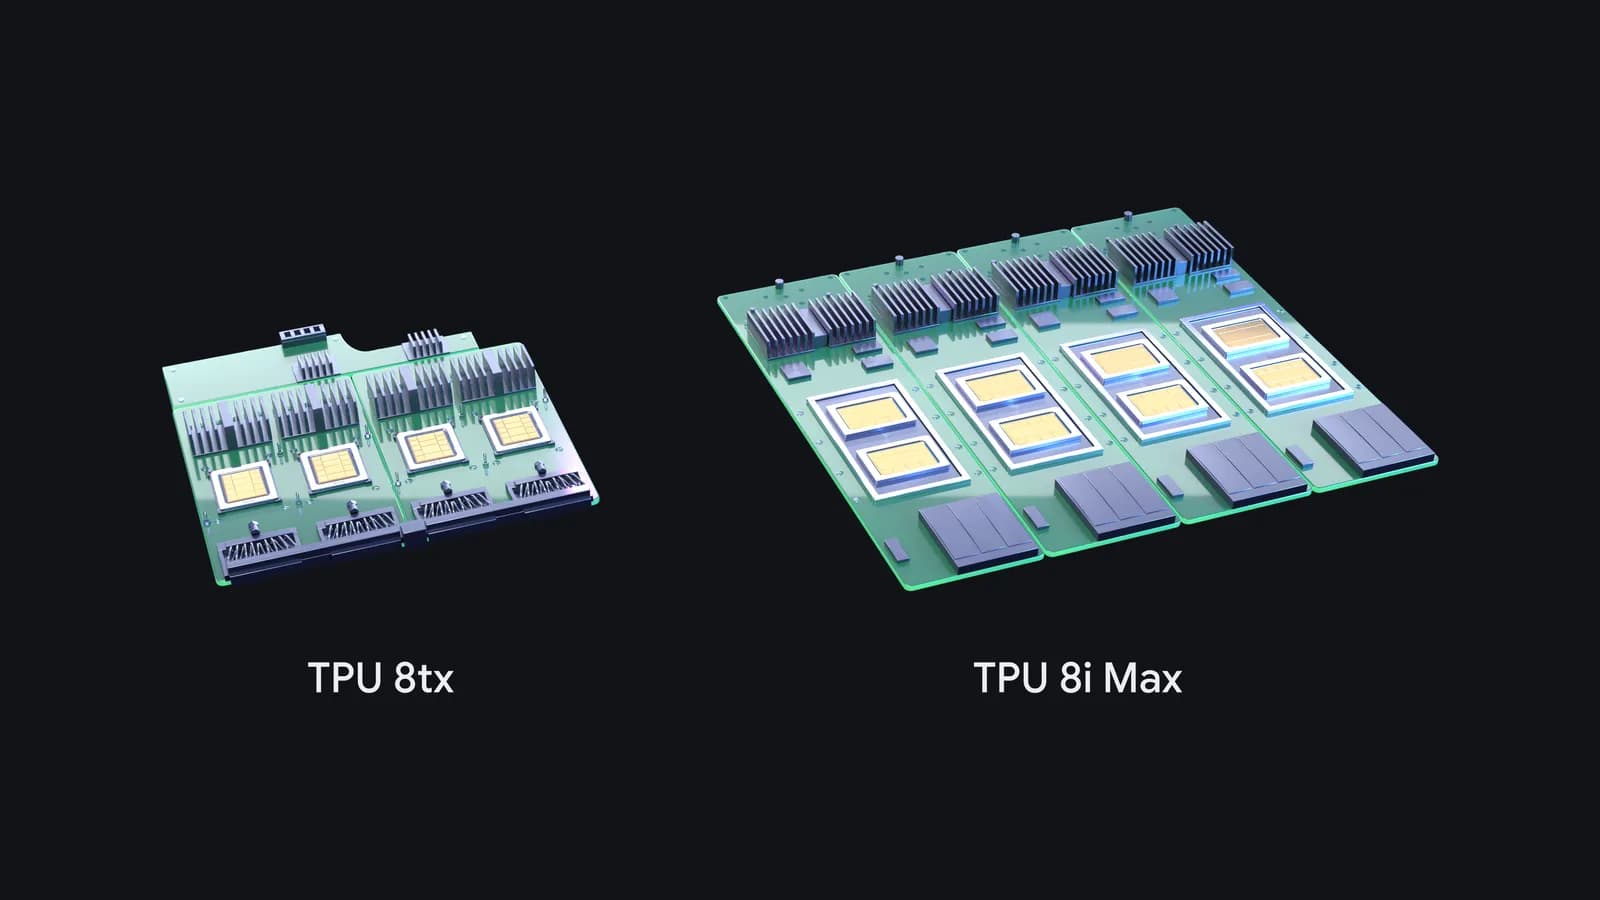
O Google apresentou duas novas versões de seus aceleradores de inteligência artificial, o TPU 8tx e o TPU 8i Max. A informação foi publicada pelo Tecnoblog nesta segunda-feira (9) e completa a família de quatro modelos da oitava geração de Tensor Processing Units, os chips próprios da empresa para executar cargas de trabalho de IA.
Para quem usa apenas aplicativos de IA, a sigla TPU pode parecer distante. Na prática, esses componentes ajudam a determinar quanto custa e quanto tempo leva para treinar ou executar um modelo. A evolução dos aceleradores influencia serviços de busca, assistentes, geração de imagens, análise de documentos e ferramentas de programação, mesmo quando o usuário nunca vê o chip instalado.
O que é uma TPU
TPU significa Tensor Processing Unit, ou unidade de processamento de tensores. Tensores são estruturas matemáticas usadas por redes neurais para representar dados e realizar operações em grandes blocos. CPUs são versáteis e GPUs são muito eficientes em operações paralelas, mas uma TPU é desenhada desde o início para determinados padrões de cálculo comuns em aprendizado de máquina.
Essa especialização pode melhorar a eficiência em serviços que executam modelos em larga escala. Um provedor de nuvem consegue escolher diferentes tipos de acelerador conforme a tarefa: treinamento de um modelo, inferência para responder a usuários, processamento de vídeos ou análise de grandes conjuntos de dados. A escolha não depende apenas de velocidade bruta. Memória, comunicação entre chips, consumo de energia e disponibilidade também pesam.
O que muda com o TPU 8tx e o 8i Max
O Tecnoblog informa que os dois novos componentes completam a oitava geração de TPUs do Google. A empresa posiciona a linha para tarefas que exigem maior capacidade de processamento e transferência de dados. O modelo 8tx é associado a cargas de computação que precisam distribuir operações entre aceleradores, enquanto o 8i Max aparece como uma solução voltada a tarefas com janelas de contexto longas.
Janela de contexto é a quantidade de informação que um modelo consegue considerar em uma solicitação. Em um chatbot, ela pode incluir uma conversa extensa. Em uma ferramenta de programação, pode abranger vários arquivos e instruções de um projeto. Em análise documental, permite comparar contratos ou relatórios mais longos. A capacidade maior é útil, mas exige memória e interconexões capazes de movimentar esses dados sem criar um gargalo.
O artigo do Tecnoblog destaca avanços em criptografia e velocidade de transferência de dados. Isso importa porque os aceleradores não trabalham isolados. Modelos modernos são divididos entre vários chips, servidores e sistemas de armazenamento. Se a comunicação entre essas partes for lenta, uma unidade de cálculo mais rápida pode passar boa parte do tempo esperando dados.
Por que o hardware é decisivo na corrida da IA
O debate sobre IA costuma se concentrar em modelos, interfaces e aplicativos, mas a infraestrutura define o que pode ser oferecido em escala. Um modelo com respostas mais complexas pode exigir mais memória e mais operações por consulta. Um recurso de vídeo consome mais processamento do que uma classificação de texto. Um assistente que mantém histórico por mais tempo aumenta a quantidade de informação que precisa ser lida a cada interação.
Aceleradores próprios ajudam o Google a controlar parte desse caminho. A empresa pode ajustar hardware, compiladores e serviços de nuvem para que trabalhem juntos. Essa integração também cria dependência de uma arquitetura específica. Desenvolvedores que usam ferramentas otimizadas para uma TPU podem precisar adaptar código, bibliotecas e modelos para outro ambiente no futuro.
Transferência é tão importante quanto cálculo
Em sistemas distribuídos, o tempo gasto para mover dados entre chips pode limitar o resultado. É parecido com uma equipe que tem profissionais rápidos, mas compartilha informações por um canal congestionado. Uma geração de aceleradores precisa aumentar a capacidade de computação e também reduzir os intervalos em que as unidades ficam ociosas.
O foco em velocidade de transferência tem impacto direto em tarefas de contexto longo e em modelos com muitos parâmetros. Quando uma solicitação precisa consultar várias partes de uma rede neural, a infraestrutura tem de localizar os dados e entregá-los ao componente correto. Melhorias nessa comunicação podem reduzir latência e aumentar a quantidade de tarefas que um mesmo conjunto de servidores processa.
O que isso muda para desenvolvedores brasileiros
O lançamento não significa que alguém possa comprar um TPU 8tx para instalar em um computador pessoal. Esses aceleradores fazem parte de infraestrutura de nuvem e de centros de dados. O efeito para desenvolvedores brasileiros aparece por meio das plataformas que oferecem treinamento, hospedagem e inferência. Se a capacidade do Google crescer, serviços de IA podem ganhar novas funções ou preços diferentes conforme a empresa repasse eficiência para os planos.
Para equipes que treinam ou executam modelos, a notícia reforça a importância de escolher a infraestrutura olhando para o trabalho inteiro. Um chip mais rápido pode não ser a melhor opção se a biblioteca usada pelo projeto não for compatível, se os dados estiverem longe do servidor ou se o custo de transferência for alto. Também é importante verificar disponibilidade regional, proteção de dados, suporte a português e facilidade de migrar o modelo para outro provedor.
Empresas brasileiras que trabalham com documentos, atendimento ou automação podem se beneficiar de modelos mais eficientes, mas precisam medir o resultado no próprio cenário. Uma queda na latência é valiosa em uma aplicação interativa. Já em uma tarefa noturna de processamento, o consumo total e o preço podem ser mais relevantes. A escolha deve partir do objetivo do produto, não apenas do nome do acelerador.
Mais chips não resolvem todos os problemas
O hardware é uma parte da equação. Dados ruins, modelos mal ajustados e sistemas sem monitoramento continuam produzindo respostas imprecisas em servidores potentes. O aumento de capacidade também traz desafios ambientais e operacionais, como consumo de energia, refrigeração e planejamento de redes. Para o Google, isso significa equilibrar desempenho com eficiência em uma escala que poucos operadores conseguem atingir.
A oitava geração de TPUs mostra que a corrida da inteligência artificial está avançando em camadas cada vez mais específicas. A disputa não acontece somente entre aplicativos, mas também entre arquiteturas de chip, bibliotecas, sistemas de memória e redes de data center. Para o usuário, o resultado esperado é uma IA mais rápida e capaz de lidar com tarefas maiores. Para o desenvolvedor, a lição é acompanhar a infraestrutura porque ela define quais ideias podem sair do protótipo e funcionar para milhões de pessoas.
Fonte: Tecnoblog, Google apresenta versões mais potentes de seus chips de IA.