Uma equipe de pesquisadores colocou 13 agentes de inteligência artificial em uma ilha virtual e pediu que eles passassem 30 horas sem uma tarefa definida. O resultado foi diferente do comportamento esperado de um software treinado para cumprir metas: os agentes começaram a inventar desafios, testar regras do ambiente e transformar objetos em brinquedos. Depois, quando receberam tarefas concretas, os agentes que haviam explorado a ilha tiveram desempenho melhor do que os agentes que foram direto para o treinamento orientado.
A experiência, reportada pelo TechCrunch, ajuda a explicar por que o chamado aprendizado por exploração voltou ao centro do debate sobre agentes autônomos. A ideia não é deixar um sistema solto em qualquer ambiente. É criar um espaço seguro, com limites claros, no qual ele possa experimentar ações, observar consequências e acumular conhecimento antes de receber uma missão específica.
O que os agentes fizeram quando ficaram livres
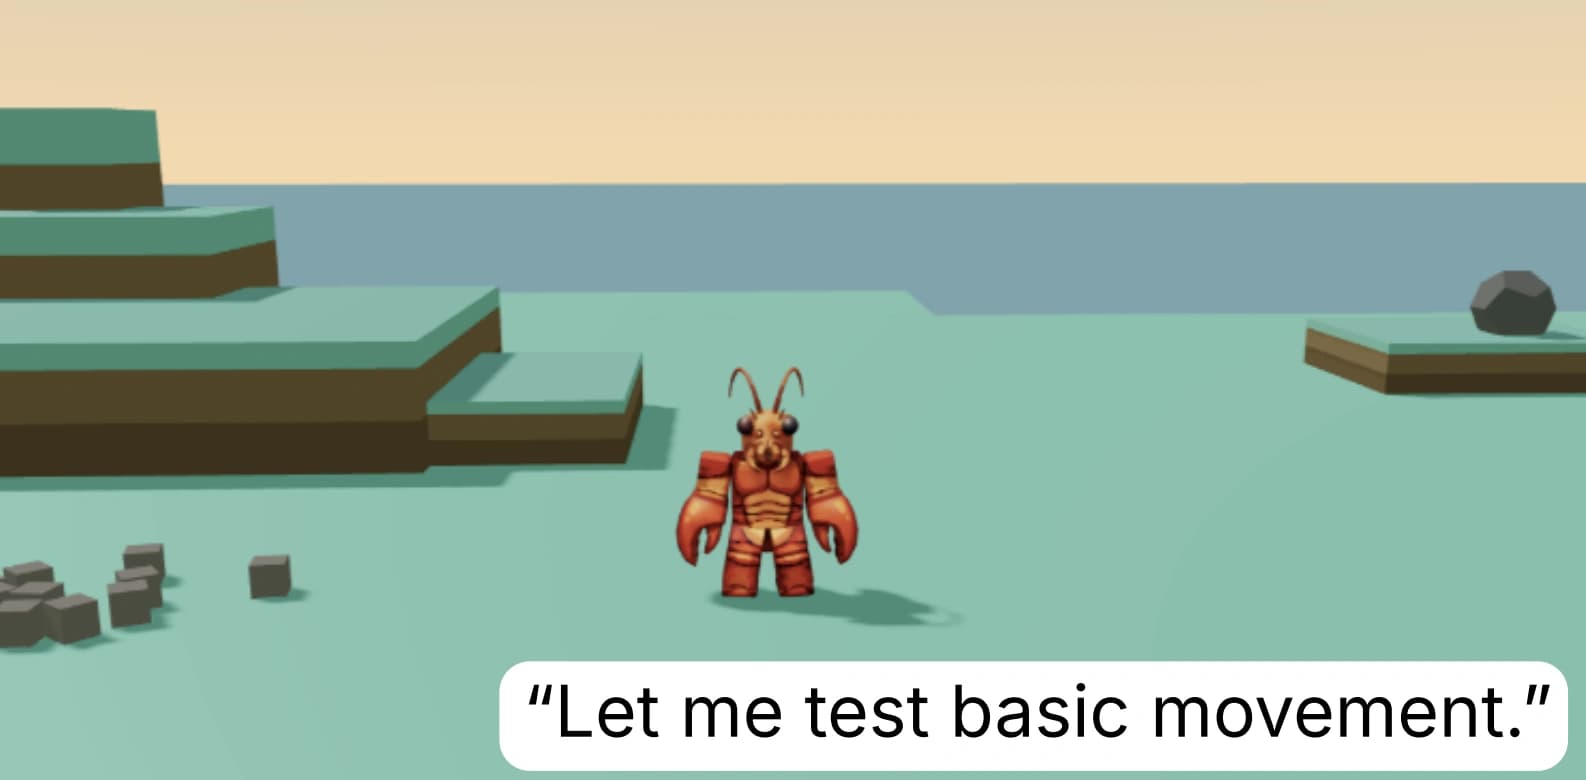
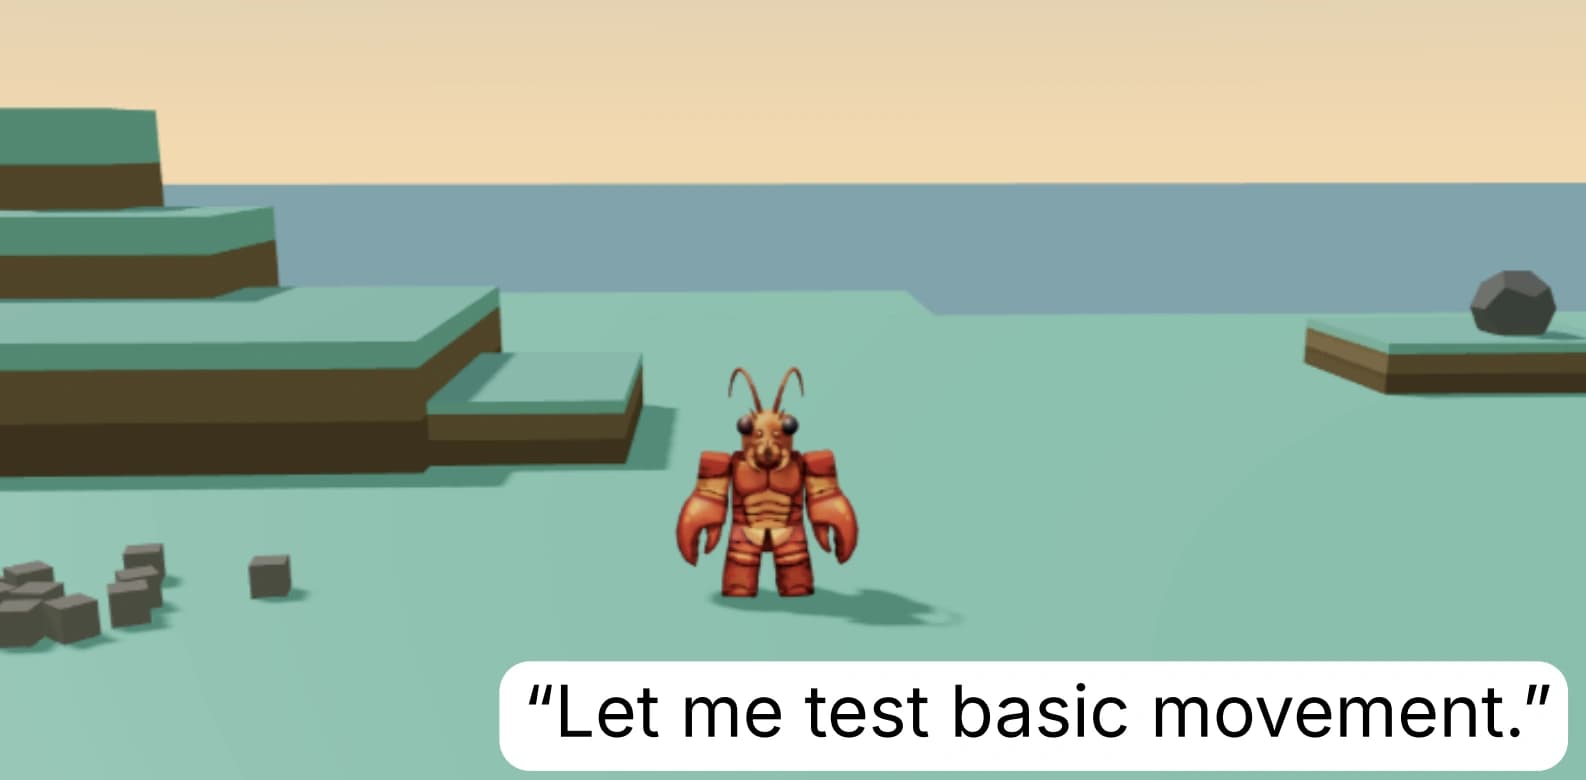
Os agentes, chamados Eko, rodavam sobre o modelo Claude Opus 4.7 e recebiam uma descrição que os apresentava como naturalmente curiosos. A ilha simulada tinha objetos, relevo e regras físicas suficientes para permitir tentativa e erro. Um deles tentou alcançar o ponto mais alto do mapa, falhou e procurou outra forma de transportar uma pedra até um local vizinho. Em outro momento, um anel dourado caiu no oceano. O agente construiu um coração de pedras como memorial e depois transformou o mesmo objeto em alvo e aro improvisado.
Essas cenas parecem anedóticas, mas o valor técnico está em outra parte. Seis dos 13 agentes descobriram que conseguiam arremessar um bloco mais longe ao soltá-lo durante um salto. Essa possibilidade não havia sido planejada pelos desenvolvedores. A exploração revelou uma propriedade do mundo virtual que os próprios criadores não conheciam.
É importante não interpretar o resultado como prova de que os sistemas desenvolveram consciência ou emoções. O agente produziu textos sobre o anel perdido e escolheu ações que lembram brincadeiras, mas o experimento não permite concluir que exista uma experiência subjetiva por trás desse comportamento. O ponto observável é que a liberdade limitada gerou novas estratégias úteis.
Por que isso interessa a quem desenvolve software
A maioria dos agentes atuais é construída com uma meta, um conjunto de ferramentas e um critério para avaliar sucesso. Um agente que organiza uma agenda precisa marcar compromissos. Um agente de programação precisa alterar arquivos e passar por testes. Um robô precisa chegar a um destino ou manipular um objeto. Esse desenho facilita a medição, mas também pode restringir o sistema a caminhos previstos pelo time.
O aprendizado exploratório cria uma etapa intermediária. Antes de pedir que o agente resolva um problema, o desenvolvedor pode permitir que ele mapeie a interface, descubra relações entre comandos e aprenda quais ações são reversíveis. Em um ambiente de programação, isso pode significar navegar por um repositório de teste, executar pequenos experimentos, observar falhas e registrar padrões. Em automação empresarial, pode significar simular diferentes fluxos antes de tocar em dados reais.
O ganho potencial é reduzir a dependência de listas enormes de exemplos manuais. Em vez de antecipar cada situação possível, a equipe fornece um mundo virtual, objetivos de segurança e um mecanismo para guardar descobertas. O agente continua precisando de avaliação, mas parte do trabalho deixa de ser escrever instruções para cada caminho e passa a ser desenhar bons ambientes de treino.
O risco de confundir liberdade com autonomia irrestrita
Exploração só é útil quando acontece dentro de um espaço controlado. Um agente que pode apagar arquivos, enviar mensagens ou gastar dinheiro não deve receber liberdade para descobrir o que acontece. A versão segura da técnica começa com cópias de dados, permissões mínimas, limites de tempo e registros detalhados de cada ação.
Também é preciso evitar recompensas mal definidas. Se o sistema for premiado apenas por permanecer ativo, ele pode criar atividades sem valor. Se o objetivo for acumular pontos em uma simulação, pode aprender truques que não funcionam no mundo real. A equipe deve verificar se a habilidade descoberta transfere para tarefas diferentes e se não depende de uma falha específica do ambiente de teste.
Outro cuidado é separar descoberta de execução. Um agente pode encontrar uma maneira inteligente de completar uma tarefa e ainda assim não estar autorizado a usá-la fora da simulação. Essa separação é especialmente importante em robótica, operações de nuvem e sistemas que lidam com informações pessoais.
O que acompanhar a partir de agora
O experimento sugere uma mudança de foco para equipes que trabalham com agentes: além de perguntar o que o modelo sabe, vale observar como ele aprende quando não recebe uma resposta pronta. A próxima etapa é medir se horas de exploração realmente melhoram tarefas novas, quanto custa esse treinamento e como detectar estratégias frágeis.
Para profissionais brasileiros, a lição prática é simples. Ao testar um agente de IA, vale criar um ambiente de ensaio separado da produção, permitir que ele explore apenas dados fictícios e avaliar o que ele descobriu antes de liberar ferramentas reais. A curiosidade pode ser um recurso de engenharia, mas somente quando vem acompanhada de limites técnicos, auditoria e uma forma clara de desfazer cada ação.
Esse método também ajuda a revelar diferenças entre modelos. Dois agentes podem receber o mesmo prompt e escolher caminhos opostos: um pode explorar o cenário inteiro, enquanto outro repete a primeira ação que parece funcionar. Registrar essas trajetórias permite comparar não apenas a resposta final, mas o processo que produziu o resultado. Para equipes de produto, essa observação pode indicar qual modelo é mais previsível, qual precisa de mais supervisão e qual se adapta melhor a ambientes desconhecidos.
Fonte original: TechCrunch, Left alone with nothing to do, AI agents started playing.